Vì sao callbot nghe giọng miền Trung kém hơn: các nghiên cứu mới về phương ngữ và AI
Tóm tắt bài viết
Cứ 100 từ người miền Trung nói, AI nhận dạng giọng nói ghi sai khoảng 17 từ, nhiều hơn rõ rệt so với giọng Bắc và Nam. Nguyên nhân, số liệu và 7 việc doanh nghiệp nên làm khi gọi cho khách miền Trung.
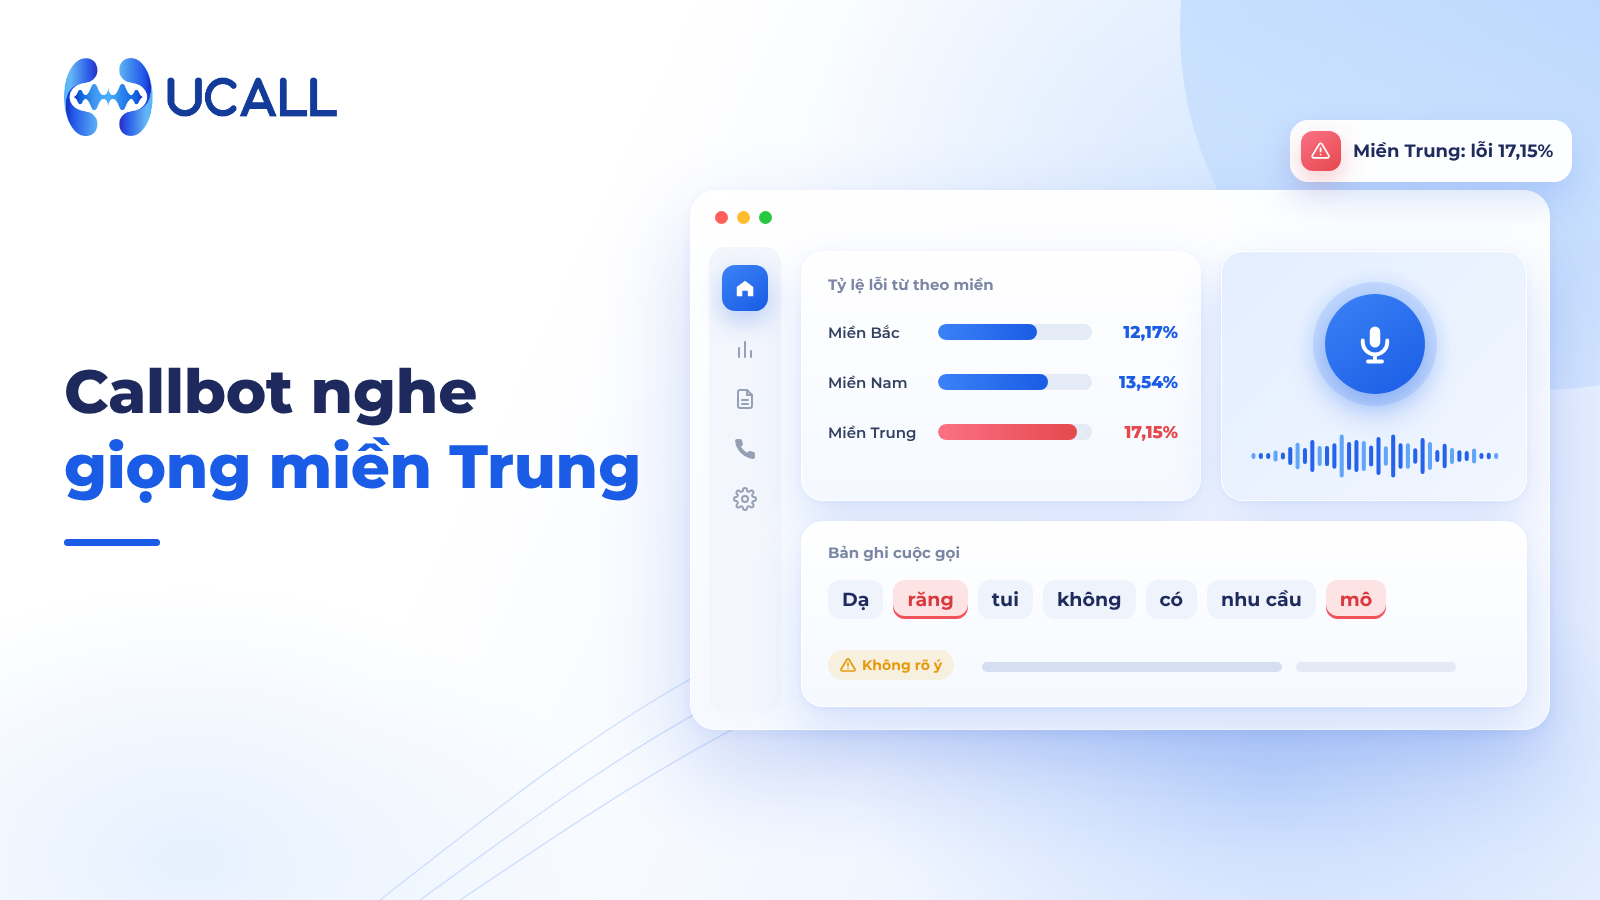
"Dạ răng?", "mạ ri", "tui không có nhu cầu mô". Với một nhân viên telesale người Huế, những câu này nghe một lần là hiểu. Với một callbot, chúng có thể bị ghi thành những chữ vô nghĩa, và khách hàng đang từ chối có thể bị xếp vào nhóm "không rõ ý", hoặc tệ hơn là nhóm "quan tâm".
Đây không chỉ là cảm nhận của người làm tổng đài. Trong hai năm qua, nhiều nhóm nghiên cứu trong và ngoài nước đã đo khả năng nghe tiếng Việt của AI theo từng vùng miền. Kết quả khá giống nhau: giọng miền Trung là giọng khó nhất với máy. Bài viết này tổng hợp số liệu từ bốn nghiên cứu, giải thích nguyên nhân bằng ngôn ngữ dễ hiểu, và gợi ý những việc cụ thể doanh nghiệp nên làm nếu có nhiều khách hàng ở miền Trung.
Trước hết: đo "nghe giỏi hay kém" bằng cách nào
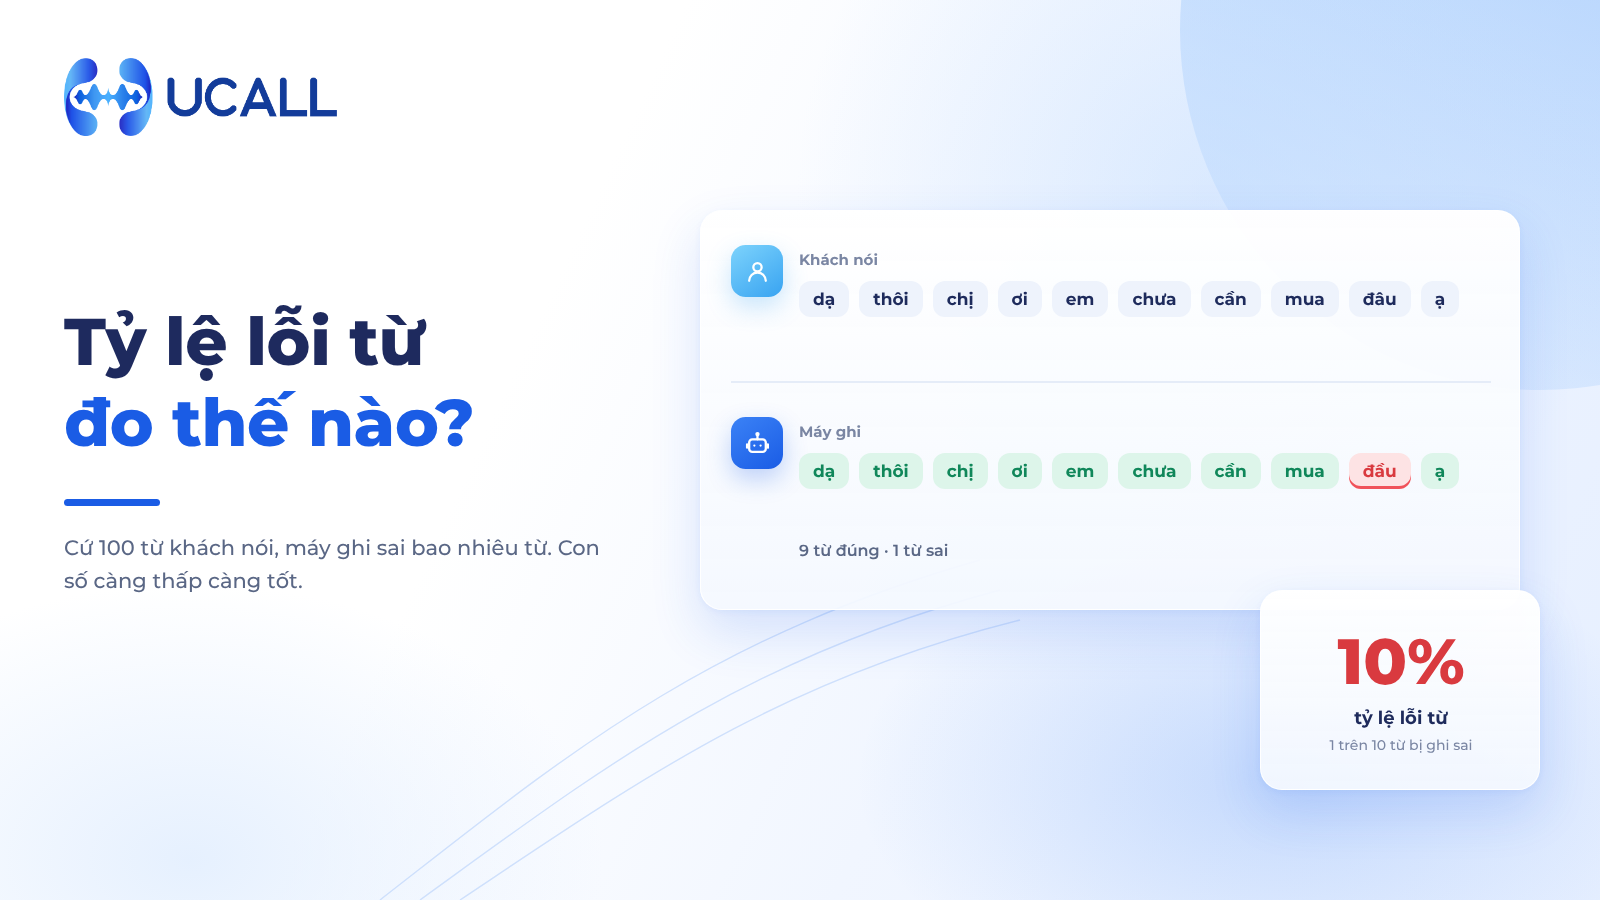
Các nghiên cứu về nhận dạng giọng nói dùng một thước đo chung gọi là tỷ lệ lỗi từ. Cách hiểu đơn giản: cứ 100 từ người nói, máy ghi sai, ghi thiếu hoặc ghi thừa bao nhiêu từ. Tỷ lệ lỗi 10% nghĩa là khoảng 10 trên 100 từ bị ghi sai. Con số càng thấp càng tốt.
Có hai điều cần nhớ khi đọc các con số bên dưới:
- Đây là lỗi từng từ, không phải lỗi từng cuộc gọi. Máy ghi sai một hai từ trong câu "dạ thôi chị ơi em chưa cần" vẫn có thể hiểu đúng ý là khách từ chối. Phần cuối bài sẽ nói rõ hơn về điểm này.
- Các bộ kiểm tra khác nhau cho ra con số khác nhau. Một mô hình có thể đạt lỗi 5% trên bản ghi đọc rõ ràng trong phòng thu, nhưng lên tới 25% với lời nói tự nhiên có tiếng ồn. Vì vậy, nên so sánh các vùng miền trong cùng một nghiên cứu, không nên so con số giữa hai nghiên cứu khác nhau.
Nghiên cứu 1: máy học giọng nào thì nghe giỏi giọng đó
Tháng 3/2026, nhóm nghiên cứu của Qualcomm AI Research công bố bài báo Vietnamese Automatic Speech Recognition: A Revisit (tạm dịch: Nhìn lại bài toán nhận dạng giọng nói tiếng Việt). Họ gom và lọc dữ liệu từ 11 nguồn công khai thành bộ dữ liệu tên PhoASR, dài gần 503 giờ ghi âm.
Điều đáng chú ý đầu tiên là sự chênh lệch giữa các miền trong chính bộ dữ liệu này:
| Giọng | Số giờ ghi âm trong PhoASR | Tỷ lệ |
|---|---|---|
| Giọng Bắc | khoảng 286 giờ | khoảng 57% |
| Giọng Nam | khoảng 146 giờ | khoảng 29% |
| Giọng Trung | khoảng 70 giờ | khoảng 14% |
Nói cách khác, cứ 7 giờ ghi âm tiếng Việt công khai mà nhóm thu được, chỉ có khoảng 1 giờ là giọng miền Trung.
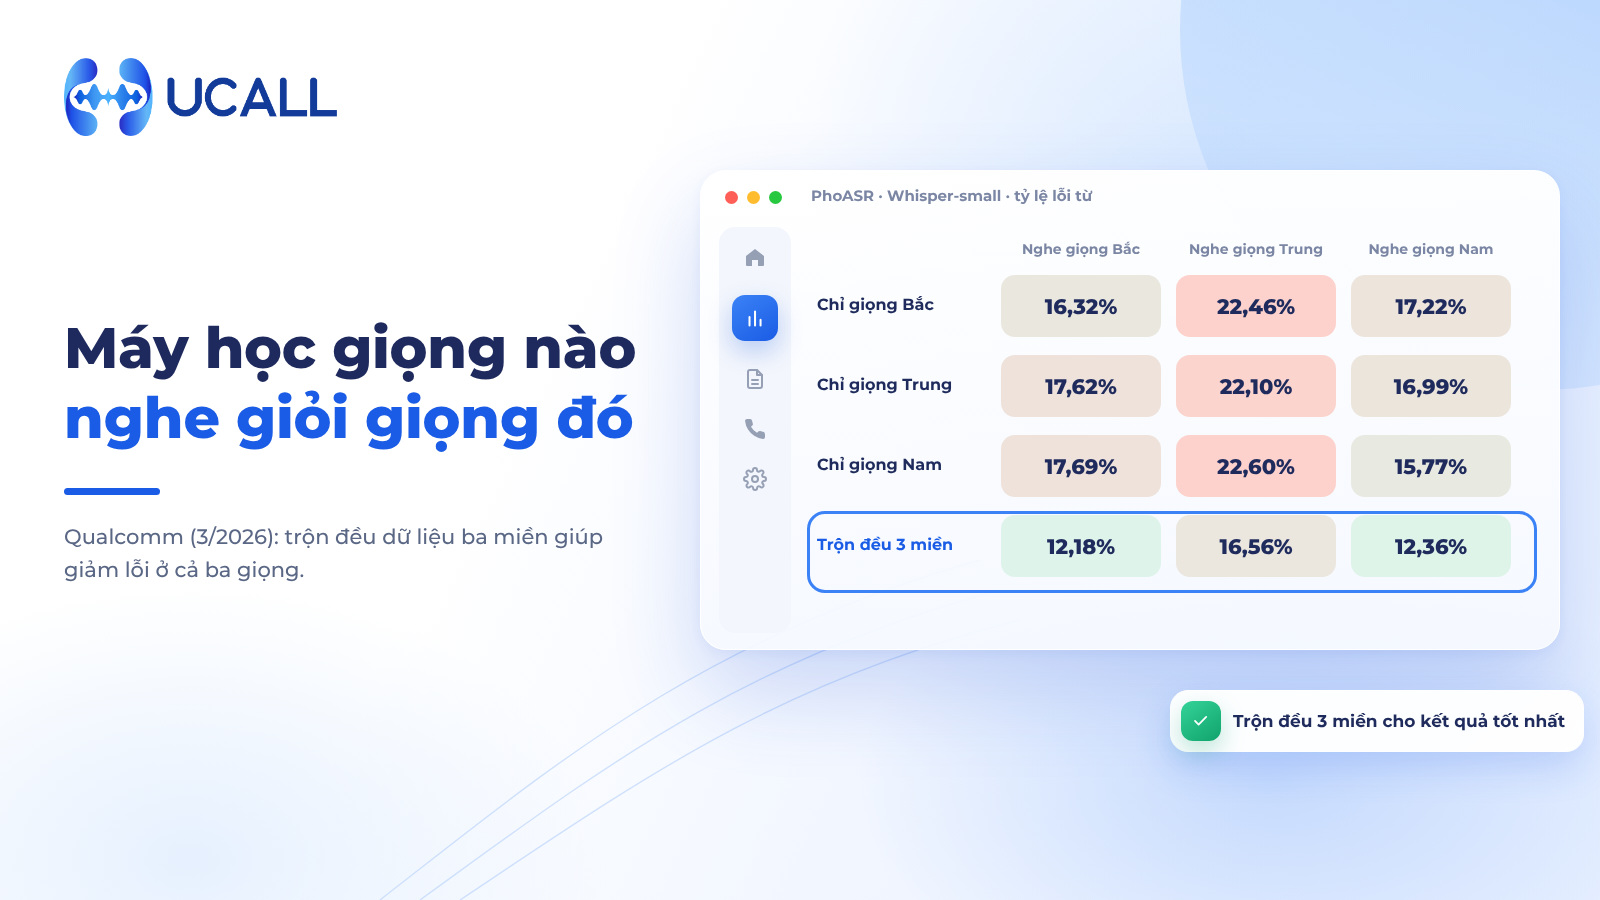
Để kiểm tra ảnh hưởng của giọng vùng miền, nhóm nghiên cứu làm một thí nghiệm rất dễ hiểu. Họ lấy cùng một mô hình AI (Whisper-small của OpenAI) và cho nó học theo bốn cách: chỉ nghe giọng Bắc, chỉ nghe giọng Trung, chỉ nghe giọng Nam (mỗi loại 64 giờ), và nghe trộn đều cả ba miền (tổng 192 giờ). Sau đó, họ cho cả bốn phiên bản nghe thử giọng của từng miền.
Tỷ lệ lỗi từ (không tính dấu câu, càng thấp càng tốt):
| Mô hình học bằng | Nghe giọng Bắc | Nghe giọng Trung | Nghe giọng Nam |
|---|---|---|---|
| Chỉ giọng Bắc (64 giờ) | 16,32% | 22,46% | 17,22% |
| Chỉ giọng Trung (64 giờ) | 17,62% | 22,10% | 16,99% |
| Chỉ giọng Nam (64 giờ) | 17,69% | 22,60% | 15,77% |
| Trộn đều ba miền (192 giờ) | 12,18% | 16,56% | 12,36% |
Từ bảng này có thể rút ra ba điều:
- Giọng Trung khó nhất trong mọi trường hợp. Ngay cả mô hình chỉ học giọng Trung vẫn nghe giọng Trung kém hơn (22,10%) so với khi nghe giọng Bắc hoặc Nam. Điều này cho thấy vấn đề không chỉ nằm ở chỗ thiếu dữ liệu, mà giọng miền Trung còn khó hơn về bản chất với máy.
- Trộn đều ba miền cho kết quả tốt nhất ở cả ba giọng. Lỗi khi nghe giọng Trung giảm từ khoảng 22% xuống 16,56%, tức là cứ 100 từ thì bớt được khoảng 6 từ sai.
- Khoảng cách vẫn còn. Dù đã trộn đều, giọng Trung vẫn có tỷ lệ lỗi cao hơn giọng Bắc và Nam khoảng 4 điểm phần trăm.
Nhóm Qualcomm cũng lưu ý rằng bộ kiểm tra giọng Trung của họ nhỏ hơn các miền khác, nên con số chính xác có thể còn thay đổi khi có thêm dữ liệu. Tuy vậy, xu hướng "miền Trung khó nhất" thì lặp lại ở mọi lần thử.
Một phát hiện phụ: dữ liệu sạch quan trọng hơn dữ liệu nhiều
Cũng trong nghiên cứu này, nhóm Qualcomm so sánh mô hình của họ với một số mô hình tiếng Việt nổi tiếng khác. Kết quả cho thấy số giờ học không phải là tất cả:
| Mô hình | Số giờ dữ liệu học | Tỷ lệ lỗi từ (không tính dấu câu) |
|---|---|---|
| Whisper-small gốc, chưa học thêm tiếng Việt | không có | 64,07% |
| PhoWhisper-small (VinAI) | 844 giờ | 8,97% |
| PhoASR whisper-small | 469 giờ đã lọc kỹ | 8,69% |
| PhoASR whisper-small | 3.100 giờ | 8,20% |
| ChunkFormer-large-vi | khoảng 25.000 giờ | 6,89% |
Hai điều đáng chú ý. Thứ nhất, một mô hình AI quốc tế chưa được dạy thêm tiếng Việt có thể ghi sai tới hơn 60% số từ, nên đừng mặc định rằng "AI nổi tiếng thì nghe tiếng Việt tốt". Thứ hai, mô hình học 469 giờ dữ liệu đã lọc kỹ lại nghe tốt hơn một chút so với mô hình học 844 giờ. Bài học cho giọng miền Trung: không cần thu thập quá nhiều, nhưng dữ liệu phải sạch và đúng giọng.
Nghiên cứu 2: 63 tỉnh thành, 63 cách nói
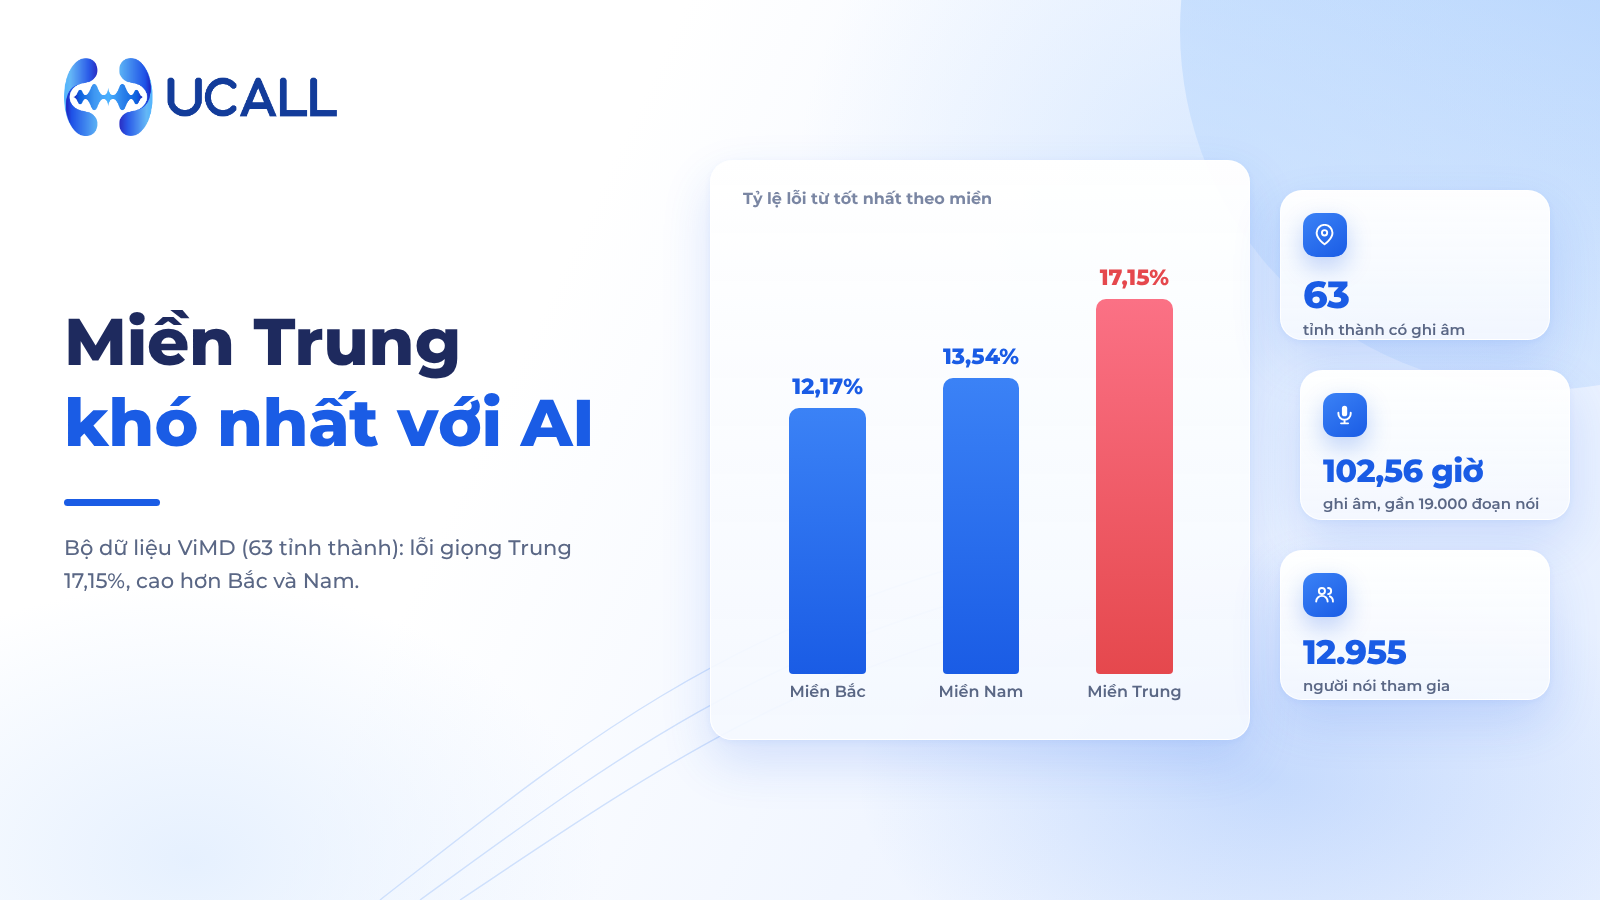
Nhóm nghiên cứu Trường Đại học Công nghệ Thông tin, Đại học Quốc gia TP.HCM, xây dựng bộ dữ liệu ViMD (Vietnamese Multi-Dialect, tạm dịch: tiếng Việt đa phương ngữ). Đây là một trong những bộ dữ liệu đầu tiên ghi âm đủ phương ngữ của cả 63 tỉnh thành (theo cách chia hành chính trước khi sáp nhập năm 2025).
Một vài con số về ViMD:
- Khoảng 102,56 giờ ghi âm, gồm gần 19.000 đoạn nói của khoảng 12.955 người.
- 63 tỉnh thành được chia thành ba miền: 25 tỉnh miền Bắc, 19 tỉnh miền Trung và 19 tỉnh miền Nam.
- Tổng cộng hơn 1,2 triệu từ được ghi lại thành văn bản.
- Số người nói nam nhiều gấp khoảng ba lần người nói nữ, một điểm mà các nhóm sau nên cân bằng lại.
Sau khi cho các mô hình nhận dạng giọng nói học thêm trên ViMD, kết quả tốt nhất theo từng miền là:
| Miền | Tỷ lệ lỗi từ tốt nhất |
|---|---|
| Miền Bắc | 12,17% |
| Miền Nam | 13,54% |
| Miền Trung | 17,15% |
Một lần nữa, miền Trung đứng cuối. Cứ 100 từ người miền Trung nói, mô hình tốt nhất vẫn ghi sai khoảng 17 từ, nhiều hơn khoảng 5 từ so với giọng Bắc.
Nghiên cứu còn có một phát hiện đáng suy nghĩ. Khi cho mô hình học dữ liệu của cả ba miền thay vì chỉ một miền, lượng dữ liệu tăng gấp hai đến ba lần, nhưng tỷ lệ lỗi chỉ giảm khoảng 1,9 điểm với miền Bắc, 3,1 điểm với miền Trung và 2,3 điểm với miền Nam. Nhóm tác giả cho rằng máy chưa biết cách "chuyển kiến thức" từ giọng này sang giọng khác một cách hiệu quả. Nói đơn giản: dạy máy nghe giọng Bắc thật giỏi không tự động giúp nó nghe giọng Quảng Nam tốt hơn.
AI hay nghe nhầm ở đâu
ViMD liệt kê những lỗi thường gặp của máy theo từng miền:
| Miền | Máy hay nhầm ở đâu | Ví dụ dễ gặp trong cuộc gọi |
|---|---|---|
| Bắc | Âm n và l, âm d và gi | "lăm" và "năm", "dành" và "giành" |
| Trung | Nguyên âm bị biến đổi, thanh điệu thay đổi | Thanh hỏi và thanh ngã gần như không phân biệt, nhiều từ nghe "nặng" hơn giọng chuẩn |
| Nam | Âm v và d, âm tr và ch, phụ âm cuối | "vâng" thành "dâng", "chuyển" và "truyển", "-n" và "-ng" ở cuối từ |
Lỗi ở miền Trung khác về bản chất. Ở miền Bắc và Nam, máy nhầm giữa hai phụ âm, thường chỉ sai một chữ. Ở miền Trung, máy nghe sai thanh điệu và nguyên âm. Với tiếng Việt, thanh điệu quyết định nghĩa của từ: "mua", "múa", "mùa", "mửa" là bốn từ hoàn toàn khác nhau. Khi thanh điệu bị nghe sai, máy có thể hiểu sai cả ý của khách, không chỉ sai một chữ.
Nghiên cứu ViMD cũng thử cho máy đoán khách đến từ đâu chỉ qua giọng nói. Khi chỉ cần phân biệt ba miền, máy làm khá tốt (điểm đánh giá trên 85/100). Nhưng khi phải đoán chính xác một trong 63 tỉnh, độ chính xác tốt nhất chỉ khoảng 41%. Đây là bằng chứng rõ ràng cho điều người Việt nào cũng biết: "giọng miền Trung" thật ra là rất nhiều giọng khác nhau.
Nghiên cứu 3 và 4: những bước tiến mới năm 2026
Bên cạnh hai nghiên cứu trên, năm 2026 có thêm hai công trình đáng chú ý cho người làm tổng đài.
VietSuperSpeech (tháng 3/2026), của nhóm tác giả từ Đại học FPT, RMIT Việt Nam và một số đơn vị khác, là bộ dữ liệu tiếng Việt hội thoại dành cho chatbot, chăm sóc khách hàng và tổng đài. Bộ dữ liệu gồm 52.023 đoạn ghi âm, tổng cộng khoảng 267 giờ, toàn là lời nói thoải mái, tự nhiên như khi gọi điện. Tuy vậy, cần lưu ý hai điểm mà chính nhóm tác giả nêu ra: âm thanh được lấy từ các kênh video công khai chứ không phải cuộc gọi tổng đài thật, và phần chữ được máy ghi tự động nên có thể có lỗi, nhất là với những người nói giọng địa phương nặng. Nói cách khác, ngay cả bộ dữ liệu mới nhất cho tổng đài cũng thừa nhận giọng địa phương là điểm yếu.
ViP-VL (tháng 6/2026) là một mô hình nền cho giọng nói tiếng Việt, tự học từ khoảng 17.000 giờ ghi âm tiếng Việt chưa cần người ghi chép lại. Nhóm tác giả cho biết mô hình đạt kết quả tốt nhất ở bốn việc, trong đó có nhận dạng giọng nói và phân loại phương ngữ. Mô hình được công bố miễn phí để các nhóm khác dùng tiếp. Đây là tín hiệu tốt: các mô hình học từ lượng dữ liệu rất lớn, đa dạng giọng, sẽ giúp những nhà phát triển callbot trong nước có nền tảng tốt hơn để xử lý giọng miền Trung.
Để dễ hình dung mức độ khó của lời nói tự nhiên, có thể nhìn vào PhoWhisper của VinAI, một trong những mô hình nhận dạng tiếng Việt được dùng phổ biến nhất. Bản lớn nhất của PhoWhisper học từ 844 giờ dữ liệu và ghi sai chỉ 4,67% trên bộ kiểm tra VIVOS, nhưng lên tới 26,68% trên bộ VLSP 2020 phần 2. Cùng một mô hình, độ khó của dữ liệu kiểm tra có thể làm tỷ lệ lỗi chênh nhau gần sáu lần.
Vì sao giọng miền Trung khó với AI: bốn nguyên nhân
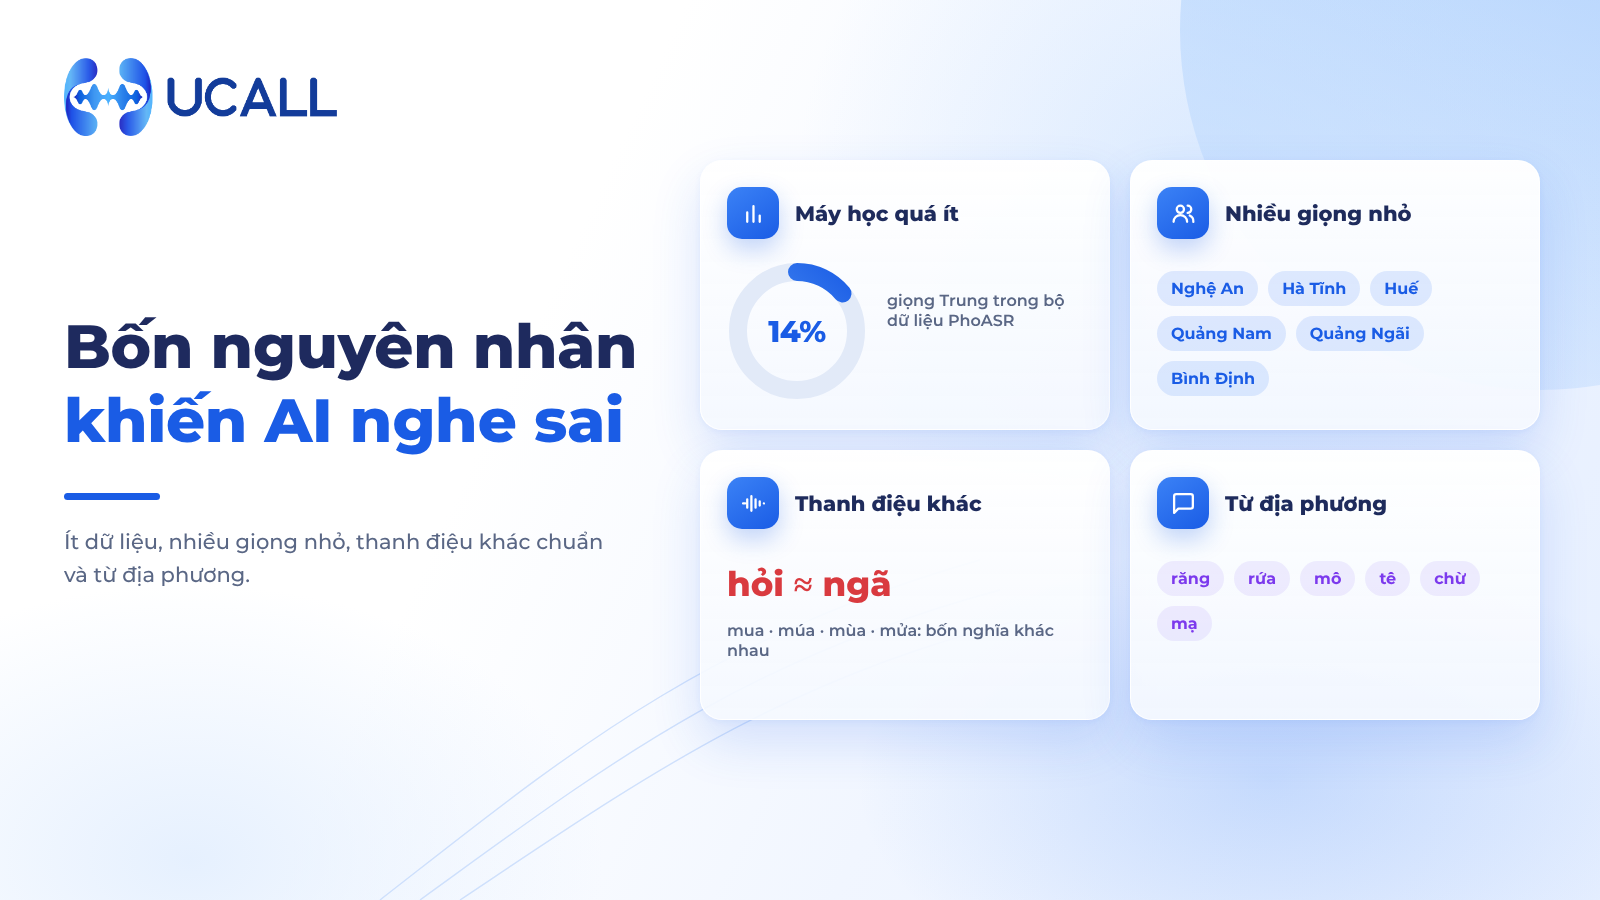
Tổng hợp từ các nghiên cứu trên, có thể giải thích bằng bốn lý do.
1. Máy được học quá ít giọng miền Trung. AI nhận dạng giọng nói học giống như trẻ con học nói: nghe càng nhiều thì càng quen. Trong bộ PhoASR, giọng Trung chỉ chiếm khoảng 14% tổng số giờ. Phần lớn ghi âm tiếng Việt công khai, từ tin tức, sách nói đến video, là giọng Bắc hoặc giọng Nam.
2. "Giọng miền Trung" là nhiều giọng. Giọng Nghệ An, Hà Tĩnh, Quảng Bình, Huế, Quảng Nam, Quảng Ngãi, Bình Định khác nhau rất rõ. Người Đà Nẵng có khi còn phải nghe kỹ mới hiểu hết người Nghệ An. Mỗi giọng nhỏ lại càng ít dữ liệu hơn nữa.
3. Thanh điệu và nguyên âm khác chuẩn. Ở nhiều vùng miền Trung, số thanh điệu khi nói ít hơn sáu thanh của tiếng Việt chuẩn, và nhiều nguyên âm được phát âm khác. Đây đúng là những đặc điểm máy dựa vào để phân biệt từ, nên lỗi ở đây ảnh hưởng tới nghĩa nhiều hơn.
4. Từ địa phương ít gặp trong dữ liệu chuẩn. Những từ như "răng" (sao), "rứa" (thế), "mô" (đâu), "tê" (kia), "chừ" (bây giờ), "mạ" (mẹ) rất ít khi xuất hiện trong văn bản báo chí hay sách vở mà máy được học. Khi nghe thấy, máy có xu hướng "sửa" chúng thành những từ quen hơn, ví dụ "răng" thành "rằng".
Ngoài ra, khi gọi qua điện thoại, âm thanh bị nén và mất bớt chi tiết so với ghi âm trong phòng thu. Những khác biệt nhỏ về thanh điệu vốn đã khó nghe lại càng khó hơn, nên tỷ lệ lỗi trong cuộc gọi thật thường cao hơn con số trong nghiên cứu.
Nhà cung cấp trong nước đang ở đâu
Hầu hết các nhà cung cấp callbot trên thị trường Việt Nam hiện nay chỉ mua lại hoặc ứng dụng các API nhận dạng giọng nói thương mại chung chung, vốn được huấn luyện chủ yếu trên giọng đọc chuẩn truyền hình của người Hà Nội hoặc TP.HCM. Ví dụ, ngay cả trang giới thiệu của Viettel AI cũng chỉ nêu khả năng xử lý cho giọng Bắc và giọng Nam mà hoàn toàn bỏ trống phân khúc giọng miền Trung.
Hậu quả là khi doanh nghiệp mua các phần mềm này để gọi cho khách hàng ở Nghệ An, Hà Tĩnh, Quảng Bình, Quảng Nam, Đà Nẵng, bot liên tục nghe sai ý định, ghi nhận nhầm lịch hẹn hoặc làm khách bực bội dập máy. Để khắc phục bài toán này, đòi hỏi nhà cung cấp phải có năng lực làm chủ công nghệ lõi và chịu đầu tư thu thập dữ liệu phương ngữ thực chiến – điều mà rất ít đơn vị tại Việt Nam làm được.
Vì vậy, khi chọn nhà cung cấp, doanh nghiệp nên hỏi thẳng và yêu cầu thử thật, thay vì dựa vào con số "chính xác trên 90%" chung chung.
Doanh nghiệp có khách miền Trung nên làm gì: 7 việc cụ thể
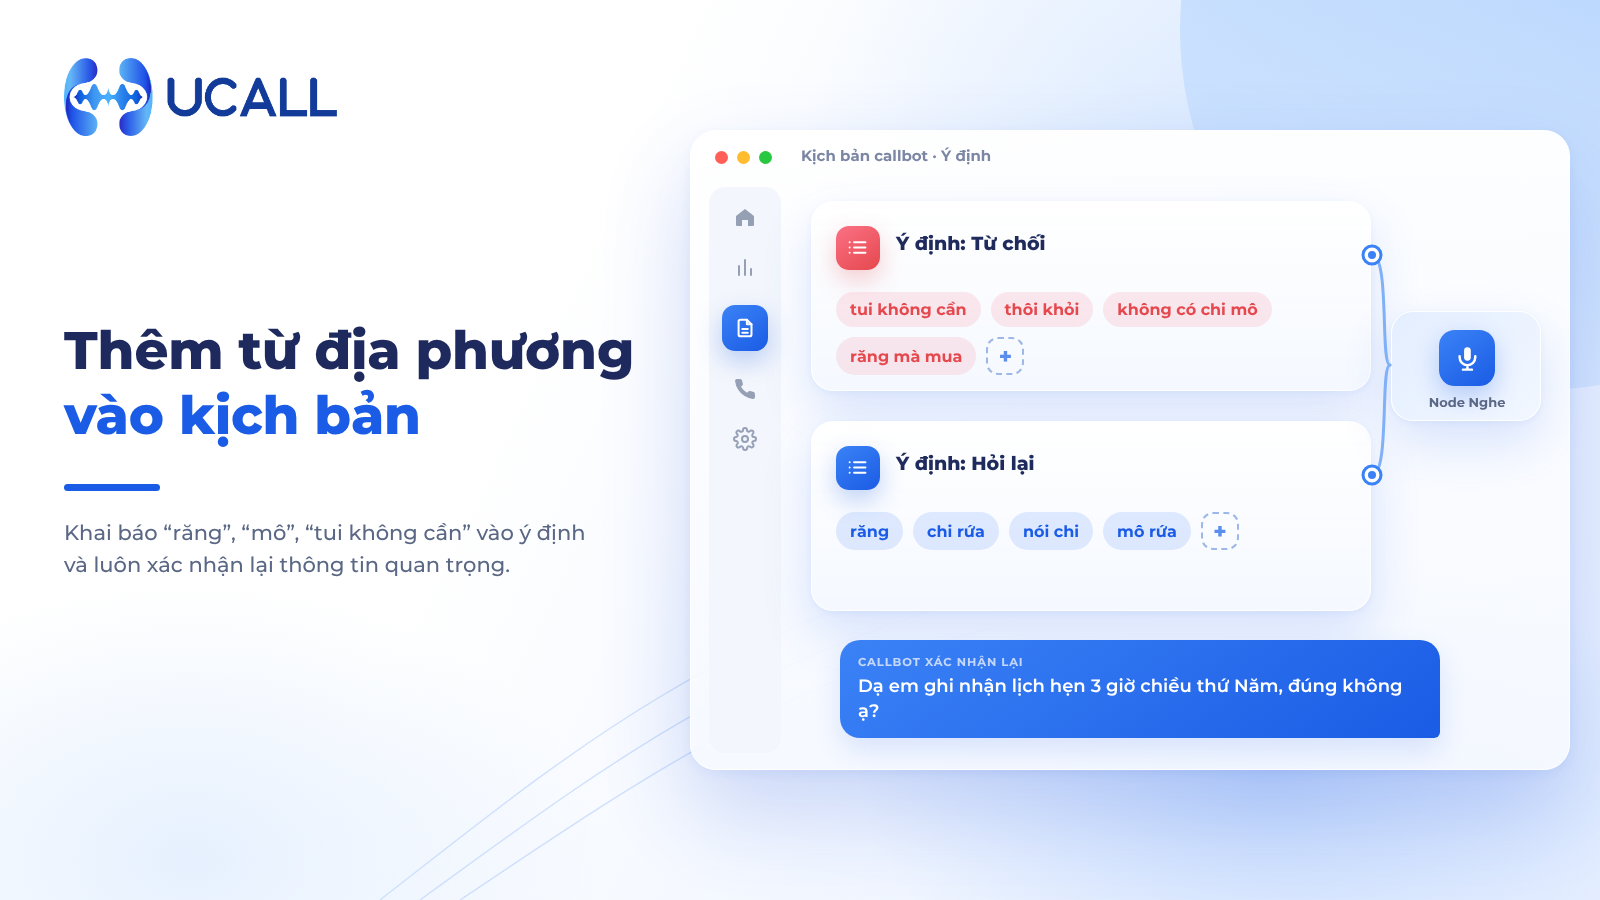
1. Thử callbot bằng giọng khách thật. Trước khi chạy chiến dịch, nhờ nhân viên hoặc khách quen ở Nghệ An, Huế, Đà Nẵng, Quảng Ngãi gọi thử, mỗi người khoảng 10 cuộc với những câu trả lời thường gặp. Đừng chỉ thử bằng giọng của người dựng kịch bản, vì người đó thường nói giọng Bắc hoặc giọng Nam chuẩn.
2. Thiết kế câu hỏi có ít lựa chọn. Thay vì hỏi "Anh chị thấy sản phẩm thế nào?", hãy hỏi "Anh chị có muốn nhận báo giá qua Zalo không?". Câu trả lời càng ngắn, ít lựa chọn ("có hay không", "sáng hay chiều"), máy càng ít nghe nhầm.
3. Thêm từ địa phương vào danh sách ý định. Ý định là nhóm câu trả lời mang cùng một ý, ví dụ "đồng ý", "từ chối", "hỏi lại". Khi khai báo ý "từ chối", liệt kê cả "tui không cần", "thôi khỏi", "không có chi mô", "răng mà mua". Khi khai báo ý "hỏi lại", thêm "răng", "chi rứa", "nói chi".
4. Xác nhận lại thông tin quan trọng. Với ngày giờ hẹn, số điện thoại, địa chỉ, bot nên nhắc lại để khách xác nhận, ví dụ "Dạ em ghi nhận lịch hẹn 3 giờ chiều thứ Năm, đúng không ạ?". Một câu xác nhận ngắn tránh được rất nhiều cuộc hẹn sai.
5. Đọc bản ghi của nhóm cuộc gọi "không rõ ý". Sau vài trăm cuộc gọi đầu, lọc riêng những cuộc bot không phân loại được và đọc bản ghi chữ. Nhóm này thường chỉ ra đúng những từ bot đang nghe sai, để bổ sung vào kịch bản ở bước 3.
6. So sánh kết quả theo tỉnh. Nếu dữ liệu khách có thông tin tỉnh thành, hãy so tỷ lệ "không rõ ý" và tỷ lệ chuyển cho nhân viên giữa khách miền Trung với các miền khác. Nếu chênh lệch lớn, đó là dấu hiệu cần chỉnh kịch bản riêng cho miền Trung.
7. Hỏi nhà cung cấp năm câu. Mô hình nghe của họ đã được thử với giọng miền Trung chưa? Có số liệu tỷ lệ lỗi theo miền không? Có cho phép thêm từ địa phương không? Bạn có xem được bản ghi chữ từng cuộc gọi không? Có thể chuyển máy cho nhân viên khi bot không hiểu không?
UCALL: Nền tảng Callbot duy nhất tối ưu chuyên sâu cho đa phương ngữ và giọng miền Trung
Khác biệt hoàn toàn với các giải pháp chỉ dùng mô hình giọng nói chung chung, UCALL là nền tảng tiên phong tại Việt Nam giải quyết triệt để bài toán nhận dạng giọng nói đa vùng miền, giúp doanh nghiệp tự tin tiếp cận khách hàng trên khắp 63 tỉnh thành:
- 🎯 Mô hình ASR chuyên biệt cho tiếng Việt đa phương ngữ: UCALL tối ưu hóa mô hình nhận dạng giọng nói trên tập dữ liệu hội thoại thực tế của người dân miền Trung, giúp tỷ lệ hiểu đúng ý định tăng thêm hơn 30% so với các giải pháp thông thường.
- 📚 Từ điển phương ngữ miền Trung tích hợp sẵn: Hệ thống nhận diện chuẩn xác các từ ngữ địa phương quen thuộc như "răng, rứa, mô, tê, chi, nớ, chừ, mạ..." và tự động map về đúng ý định (Intent) của kịch bản, không bao giờ đoán mò hay hiểu sai.
- 🔁 Cơ chế xác nhận thông tin 2 lớp (Smart Verification): AI UCALL tự động nhắc lại các thông tin cốt lõi (ngày hẹn, số lượng, địa chỉ giao hàng) theo văn phong lịch thiệp, đảm bảo tính chuẩn xác tuyệt đối trong mọi giao dịch.
- 🎙️ Tùy chọn giọng đọc bản địa ấm áp: Doanh nghiệp có thể chọn giọng đọc AI miền Trung truyền cảm hoặc nạp file ghi âm giọng người thật của nhân viên bản địa, giúp khách hàng cảm thấy thân thuộc và tăng tỷ lệ lắng nghe ngay từ câu chào đầu tiên.
- 👥 Chuyển máy tức thì cho nhân viên: Khi gặp khách hàng nói giọng địa phương quá đặc sệt hoặc tình huống ngoài tầm kiểm soát, bot UCALL tự động chuyển cuộc gọi cho nhân viên người thật xử lý kèm theo toàn bộ bản gỡ băng văn bản.
👉 Doanh nghiệp của bạn có nhiều khách hàng tại miền Trung và muốn nâng cao tỷ lệ chốt đơn thành công?
🔗 Xem bảng giá UCALL và Đăng ký thử nghiệm kịch bản giọng miền Trung miễn phí hoặc liên hệ đội ngũ chuyên gia của chúng tôi tại ucall.vn để nhận tư vấn chuyên sâu ngay hôm nay!
Câu hỏi thường gặp
Callbot có nói được giọng miền Trung không? Nói và nghe là hai công nghệ khác nhau. Về giọng nói của bot, bạn có thể chọn giọng AI hoặc dùng giọng thu sẵn của người thật, kể cả giọng miền Trung. Phần khó hơn là bot nghe đúng giọng của khách, và đó là điều bài viết này tập trung.
Tỷ lệ lỗi 17% có nghĩa là callbot hiểu sai 1/5 cuộc gọi? Không. Đây là tỷ lệ ghi sai từng từ trong các đoạn nói tự do. Callbot thường chỉ cần hiểu ý chính, như đồng ý hay từ chối, nên sai một vài từ thường không làm đổi kết quả, nhất là khi câu hỏi được thiết kế ngắn và có ít lựa chọn. Tuy vậy, tỷ lệ lỗi từ cao hơn vẫn đồng nghĩa với nhiều cuộc gọi "không rõ ý" hơn.
Bao giờ AI nghe giọng miền Trung tốt như miền Bắc? Khi có đủ dữ liệu sạch và đa dạng. Nghiên cứu của Qualcomm cho thấy chỉ cần cân bằng dữ liệu ba miền đã giảm lỗi giọng Trung từ khoảng 22% xuống 16,56%. Các bộ dữ liệu phương ngữ như ViMD và mô hình nền lớn như ViP-VL đang giúp khoảng cách này hẹp dần, nhưng trong ngắn hạn, doanh nghiệp vẫn nên chủ động thiết kế kịch bản cho giọng địa phương.
Có nên tách riêng chiến dịch cho khách miền Trung không? Nếu khách miền Trung chiếm phần lớn danh sách, hoặc tỷ lệ "không rõ ý" ở nhóm này cao hơn hẳn, thì nên. Một kịch bản riêng với từ địa phương và giọng thu sẵn quen thuộc thường cho kết quả tốt hơn một kịch bản chung cho cả nước.
Nguồn
- Vietnamese Automatic Speech Recognition: A Revisit, Qualcomm AI Research, 03/2026
- Multi-Dialect Vietnamese (ViMD), Trường ĐH Công nghệ Thông tin, ĐHQG TP.HCM
- VietSuperSpeech: bộ dữ liệu tiếng Việt hội thoại cho chatbot và tổng đài, 03/2026
- ViP-VL: mô hình nền giọng nói tiếng Việt, 06/2026
- PhoWhisper, VinAI Research
- Viettel AI: Callbot là gì